2013-07-06

iPython Notebook用のChefのCookbookを書いた

iPython Notebookが0.13.2にバージョンアップして、セットアップが自動化できそうな雰囲気がしたので勉強中のChefのcookbookにした。

iPython Notebookのパッケージインストール

apt-get install ipython-notebook で入るようになったので、これまでとは比較にならないぐらい簡単になった。レシピは次の通り。ipython-notebook本体と必要なパッケージをインストールする。
# Install packages
%w{
  python-pandas
  python-numpy
  python-scipy
  python-matplotlib
  python-nose
  ipython-notebook
}.each do |pkg|
  package pkg do
    action :upgrade
  end
end

# iPython needs sympy 0.7.2
# So use [pip install] instead of package install (0.7.1).
python_pip "sympy"
sympyだけはaptで降ってくるバージョンが古くて動作しなかったので、pipで入れている。

iPython Notebookの起動

サーバー起動時にiPython Notebookも起動して欲しいので起動もレシピにした。内容は

  • 起動ユーザー(ipynb)の作成
  • プロファイル配置ディレクトリの作成
  • 起動スクリプトの配置
  • 起動

デーモン化が面倒だったので nohup で起動するようにした。レシピは次の通り。
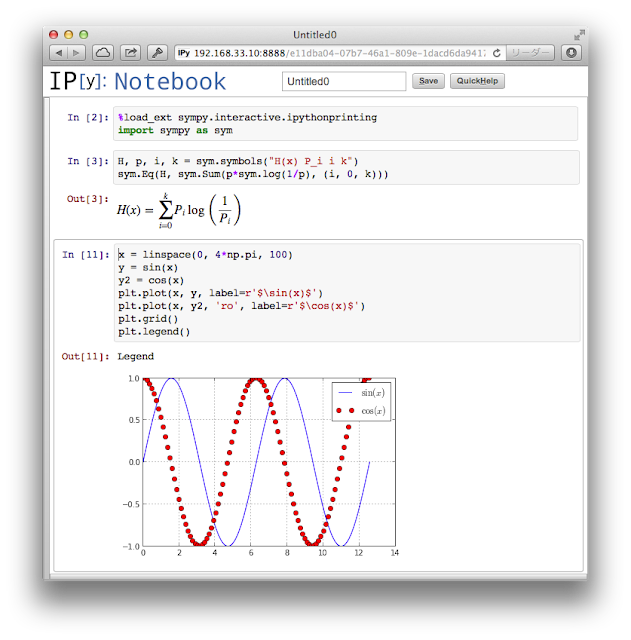
# Create launch user
group 'ipynb' do
  group_name 'ipynb'
  action :create
end

user 'ipynb' do
  comment 'User for ipython notebook'
  gid 'ipynb'
  home '/home/ipynb'
  shell '/bin/bash'
  supports :manage_home => true
  action :create
end

# Add to staff group
group 'staff' do
  action :modify
  members ['ipynb']
  append true
end

# Create serve directory
directory '/web/' do
  owner 'ipynb'
  group 'staff'
  mode '0775'
  action :create
end

directory '/web/ipython-notebook/' do
  owner 'ipynb'
  group 'staff'
  mode '0775'
  action :create
end

# 起動スクリプトの配置
template '/web/ipython-notebook/launch.sh' do
  source "launch.sh.erb"
  owner 'ipynb'
  group 'staff'
  mode 00776
end

bash 'Launch ipython notebook' do
  user 'ipynb'
  group 'staff'
  cwd '/web/ipython-notebook/'
  code >>-EOC
    nohup ./launch.sh restart
  EOC
end
起動スクリプトテンプレート、起動オプションのいくつかはAttributeから渡す。
#!/bin/bash

pid=`dirname $0`/ipynb.pid
port=<%= node['ipython-notebook']['port'] %>
ip=<%= node['ipython-notebook']['ip'] %>
ipythondir=`dirname $0`/.ipython

start() {
    if [ -f $pid ]; then
        echo "running already. pid: `cat $pid`";
        return 1;
    else
        cd `dirname $0`
        ipython notebook --pylab=inline --port=$port --ip=$ip --ipython-dir=$ipythondir &
        echo $! > $pid
    fi
}

stop() {
    if [ -f $pid ]; then
        kill `cat $pid`
        rm -f $pid
    else
        echo "Not running";
    fi
}

restart() {
    stop
    start
}

case "$1" in
  start)
    start
    ;;
  stop)
    stop
    ;;
  restart)
    restart
    ;;
  *)
    echo $"Usage: $0 {start|stop|restart}"
    exit 1
esac

exit $?

動作確認

インスタンス起動後にチェック
$ ps aux | grep python
ipynb    23612  0.0  4.0 188952 20172 ?        S    13:24   0:02 python /usr/bin/ipython notebook --pylab=inline --port=8888 --ip=* --ipython-dir=./.ipython
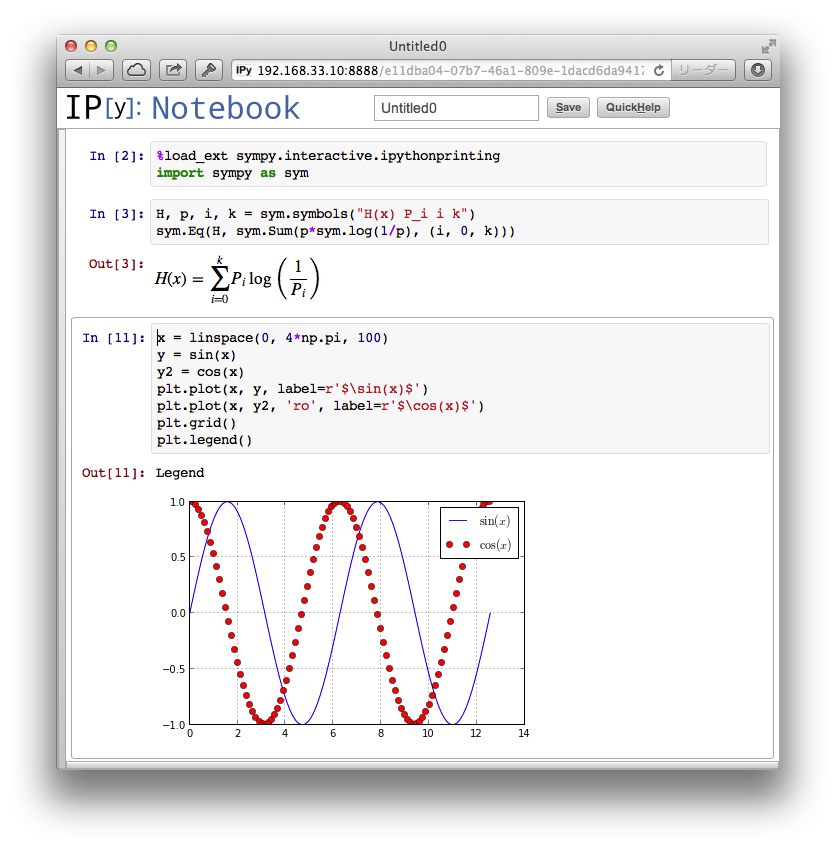
 実際に使ってみる。
OK。あとはbitbucketのプライベートリポジトリで管理しているノートをgitで引っぱってこれば個人的な要件は満たせる。

このエントリーをはてなブックマークに追加

2013-06-07

IDC FrontierさんからNASAハッカソンについて取材を受けました

NASAハッカソンのスポンサーであり、Cloudless spotチームにIDCFクラウドを無料で提供していただいたIDCFさんから受けた取材が記事になっています。 今はとにかく事例が欲しいとの事なので、後で紹介できそうな使い方であればハッカソンでもなんでも使わせてもらえそうな雰囲気でした。

このエントリーをはてなブックマークに追加

2013-06-03

NASAハッカソンでGalactic Impact部門のHonorable Mentionを受賞しました

グローバル審査の結果が出たのでエントリにします。

世界規模のハッカソンであるInternational Space Apps Challengeが4月に開催されました。昨年も同じ時期に開催されましたが、今回は開催地が44カ国、83都市。正式にサブミットされたプロジェクトは750を越えたとの事で、圧倒的な規模です。

私が参加したプロジェクトは日本ローカル2位*1となり、グローバル審査ではGalactic Impact部門のHonorable Mention(選外佳作)となりました。ハッカソンから1ヶ月以上経っていますが、今だに作業は続いているので嬉しい限りですね。

主に次の3つの機能を開発しました。
  • MODIS Cloud Maskの取りこみ、集計
  • 地図上へのマッピング
  • ソーラーパネル発電による収支のシミュレーション

サブミットしたプロジェクトページ
ソースコード (github), デモサイト

快晴率のマッピング
雲の影響を計算モデルに取りいれたソーラーパネル発電による収支のシミュレーション

二日間のハッカソン

私は、全地球上過去30年分の雲の衛星データ、MODIS Cloud Maskを利用して、太陽光エネルギーが効率良く得られる場所が見つけられるシステムを構築しようというチームに参加しました。メンバーは10人、本職のWebエンジニアが半分、エネルギーや気象方面の研究に係っている方が半分というバランスの良い構成でした。

by akiko yanagawa

とはいえ開始から発表まで30時間弱しかなく、途中MongoDBへのinsertが思ったようなパフォーマンスが出ないトラブルが発生し、処理対象のデータは日本(北緯20°~50°, 東経120°~150°)の10年分に限定する事に。

処理対象の範囲を限定したと言っても、ダウンロードしたMODISのデータは100GByte、12年分のデータが9億7000万レコードとなったのでサーバーリソースもそれなりに必要に。サーバーはスポンサー提供のIDCFクラウドが使えたので、並列処理できる所はインスタンスをガンガン追加してしのぎました。*2

この時の作業をざっと挙げると。
  • データ回り
    • MODIS Cloud Maskのデータ形式の調査
    • ダウンロードサイトから日時と領域(緯度経度)を指定して必要データを延々と落すダウンローダーの開発
    • MongoDBへの投入
    • MapReduceで集計
  • アプリケーション回り
    • ソーラーパネルの発電量の計算モデルの作成
    • アプリケーションの設計
    • サーバーサイドの開発(Ruby on Rails)
    • クライアントの開発(JavaScript)
    • Webデザイン
  • その他
    • サーバー確保
    • プロジェクトのサブミット
    • 発表準備
チームメンバーに恵まれた事もあり、スタンドプレーから生まれるチームワークとも言うべき分業体制でそれっぽく動く物が完成。発表準備はリーダーが粛々と進めており、プロジェクトの壮大な展望をプレゼン、ローカル審査は全18チーム中の2位となりました。

by akiko yanagawa

グローバル審査へ

ハッカソンの後、グローバル審査へのサブミット締切までは一週間、その間にプロジェクトの解説動画を作り、プロジェクトページを完成させなければなりません。ろくに寝ていない状況でそれを聞いてメンバー全員が沈黙。
アプリは審査に耐えられる状態では無かったのでチューニングが必要でした。私はデータの精度アップのためにひたすら積み上げ計算処理を流していました。このあたりで一回の集計が24時間を越えたのでもうMongoDBはやめてHadoopか何かしよう……と強く思ったのでした。

まとめ


  • MongoDBのMapReduceは1CPUしか使ってくれなくて辛かった
  • 集計結果をプロットするRのプログラムのバグが今だに取れなくて泣きそう
  • 太陽光エネルギーの利用法(ソーラーパネルと藻)について詳しくなった
  • 普段合う事のない、別の分野のプロフェッショナルと一緒に物を作れるのは楽しい


*1:  ローカル審査で1位と2位のプロジェクトがグローバル審査に進むルール。
*2:  最終的に管理画面で利用額を見たら4月と5月あわせて200万円ぐらいになっていた……、IDCFさん本当にスポンサーありがとうございました。(今も使わせてもらってます)

このエントリーをはてなブックマークに追加

2013-05-25

情報理論の基礎4章メモ、エントロピーからHuffman符号まで

手計算が厳しくなってきたのでiPython notebookでコードを書きつつメモ。実際に動作する物が残せて便利。 Huffman符号化は以前SICPで書いた記憶があったが、その時とは全く違ったコードになった。SchemeとPythonの違いだろうか。

4章 符号化と種々の情報量

  • エントロピー
  • KL情報量
  • Fano符号、Shannon符号
  • Huffman符号
In [128]:
%load_ext sympy.interactive.ipythonprinting
import sympy as sym

エントロピー

確率変数XのエントロピーH(X)はXの確率分布をP(X = i)として。
In [129]:
H, p, i, k = sym.symbols("H(x) P_i i k")
sym.Eq(H, sym.Sum(p*sym.log(1/p), (i, 0, k)))
Out[129]:
$$H(x) = \sum_{i=0}^{k} P_{i} \log{\left (\frac{1}{P_{i}} \right )}$$
In [130]:
def calc_entropy(P):
    return sum(map(lambda p: 0 if p == 0 else p * log2(1/p), P))
In [131]:
# Xが二値の場合、それぞれ同じ確率で出現する場合が一番エントロピーが大きい
x = linspace(0, 1, 100)
p = map(lambda x: [x, 1.0 -x], x)
plot(x,map(calc_entropy, p))
t = title('binary entropy (Figure 4.1)')

KL情報量 (Kullback-Leibler divergence)

クロスエントロピーとエントロピーの差、理想的な符号長を使った場合と、確率分布Qであるとみなして符号化したものとの差分
In [132]:
D = sym.Symbol("D(P,Q)")
p, q, i, k = sym.symbols("P_i Q_i i k")
sym.Eq(D, sym.Sum(p*sym.log(p/q), (i, 0, k)))
Out[132]:
$$D(P,Q) = \sum_{i=0}^{k} P_{i} \log{\left (\frac{P_{i}}{Q_{i}} \right )}$$
In [133]:
def calc_KLD(P, Q):
    ret = 0
    for  p, q  in zip(P, Q):
        ret += p * log2(p/q)
    return ret
In [134]:
def calc_Q(code_lens):
    ret = []
    for l in code_lens:
        ret.append(2 ** (-1 * l))
    return ret

#符号長の平均をかえす
def len_ave(P):
    return sum(map(lambda x:log2(1/x), P)) / len(P)

#切りあげた符号長の平均をかえす
def len_ceil_ave(P):
    return sum(map(lambda x:ceil(log2(1/x)), P)) / len(P)

#符号長に1を足した平均をかえす
def len_plus1_ave(P):
    return sum(map(lambda x:log2(1/x) + 1, P)) / len(P)

p = [0.4, 0.5, 0.1]
print(len_ave(p))
print(len_ceil_ave(p))
print(len_plus1_ave(p))
1.88128539659
2.33333333333
2.88128539659

Shannon fano符号

In [142]:
class ShannonFanoEncoder(object):
    def __init__(self, vals):
        p_vals = vals[:]
        p_vals.sort()
        p_vals.reverse()
        self.f_val = self.accumlate(p_vals)
        self.code_lens = self.calc_code_lens(p_vals)
        self.p_vals = p_vals
        
    def encode(self):
        codes = []
        for f, l in zip(self.f_val, self.code_lens):
            codes.append(self.get_bin_by_float(f, l))
        return codes
    
    def accumlate(self, p_val):
        ret = []
        tmp = 0
        for p in p_val:
            ret.append(tmp)
            tmp += p
        return ret
    
    def calc_code_lens(self, p_val):
        return map(lambda p: ceil(math.log(1/p, 2)), p_val)
    
    def get_bin_by_float(self, f_val, bin_len):
        """
        小数を二進数にして、小数点以下を指定した桁数でかえす
        (0.5, 4)   -> 1000
        (0.25, 4)  -> 0100
        (0.125, 4) -> 0010
        """
        bin_len = int(bin_len)
        return format(int(math.floor(f_val * (2 ** (bin_len)))), 'b').zfill(bin_len)
In [148]:
# Shannon Fano符号
P = [0.025,0.075,0.3,0.6]
shannon_fano = ShannonFanoEncoder(P)

print('入力')
print(shannon_fano.p_vals)
print('符号')
print(shannon_fano.encode())
print('符号長')
print(shannon_fano.code_lens)
print('KL情報量')
print(calc_KLD(shannon_fano.p_vals, calc_Q(shannon_fano.code_lens)))
入力
[0.6, 0.3, 0.075, 0.025]
符号
['0', '10', '1110', '111110']
符号長
[1.0, 2.0, 4.0, 6.0]
KL情報量
0.273410343316

Huffman符号

In [137]:
class HuffmanEncoder(object):
    """
    情報の各要素の出現確率を元にHuffman符号を作成する
    """
    def __init__(self, vals):
        self.p_vals = vals[:]
        self.p_vals.sort()
        self.p_vals.reverse()
        
    def encode(self):
        vals = self.p_vals[:]
        # 木の構築
        while len(vals) > 1:
            tree = self.make_tree(vals.pop(), vals.pop())
            vals.append(tree)
            vals = self.sort_tmp_tree(vals)
            
        # 木からコードを生成
        def walk(node, code, codes):
            def w(v):
                if self.is_node(v[0]):
                    walk(v[0], code + v[1], codes)
                else:
                    codes.insert(0, code + v[1])
            w(node[1])
            w(node[2])
            return codes
        return walk(vals[0], "", [])
                
    def is_node(self, v):
        return isinstance(v, tuple) and len(v) == 3
    
    def make_tree(self, v1, v2):
        return (self.sum(v1) + self.sum(v2), (v1, "1"), (v2, "0"))
       
    def sum(self, v):
        return v if isinstance(v, float) else v[0]
       
    def sort_tmp_tree(self, vals):
        return sorted(vals, cmp = lambda x, y: int(self.sum(y) - self.sum(x)))
In [147]:
# Huffman符号
P = [0.025,0.075,0.3,0.6]
huffman = HuffmanEncoder(P)
codes = huffman.encode()
code_lens = map(lambda p:len(p), codes)

print('入力')
print(huffman.p_vals)
print('符号')
print(codes)
print('符号長')
print(code_lens)
print('KL情報量')
print(calc_KLD(huffman.p_vals, calc_Q(code_lens)))
入力
[0.6, 0.3, 0.075, 0.025]
符号
['0', '10', '110', '111']
符号長
[1, 2, 3, 3]
KL情報量
0.123410343316
Huffman符号の方がKL情報量が小さい、つまり理想的な符号に近い事がわかる。


このエントリーをはてなブックマークに追加

2013-04-19

asm.jsを手書きしつつフィボナッチで速度比較をしてみる

asm.jsを触ってみたので所感など。

asm.jsはJavaScriptのサブセットで、限られた型しか使えないが高速に動作する言語との事。とりあえずどの程度速くなるのか、計算量が多くなるfibonacciの実装で試してみた。参考資料はasm.jsの仕様ぐらいしか無かったのでこれを見ながら。

で、実際に書いてみると型がゆるゆるなJavaScriptのイメージは脆くも崩れ去り、厳格な型チェックの世界である事がわかった。コンパイル言語を書いている時の頭に切り換えないと、コンパイルエラーと延々格闘する事になる。まずはasm.jsのコードは次の形式で、module exportする。
function create_my_asm_module(stdlib, foreign, heap) {
  "use asm";

  function hoge() {...}
  function fuga() {...}

  return {
    hoge: hoge,
    fuga: fuga
  }
}
asm_my_modules = create_my_asm_module(window);
関数の書き型にも決まりがあり、次の順番で記述する必要がある。
function hoge(fuga) {
  // 1)パラメータの型指定
  // 2)変数の初期化
  // 3)処理
  // 4)return句
}
次にasm.jsで書く関数の引数の型、戻り値の型を決める。引数の型はParameter Type Annotationsで記述する。
  
function calc_tax_included_price(price, tax_rate) {
    price = price|0;      // priceはint
    tax_rate = +tax_rate; // tax_rateはdouble

    //略
}
仕様にはintとdoubleしか無いのでどちらかとなる。
関数の戻り値はReturn Type Annotationsで記述する。関数内にreturnが複数個ある場合、それぞれの箇所でreturnの型が異なるとコンパイルできない。
  
return +d;  // double
return i|0; // signed int
return 1;   // double
return;     // void
で、実際にフィボナッチが動くコードと実行結果が以下。実行はAuroraバージョン22.0a2。

asm.jsの方が速いのがわかる。といってもこの程度ならまだしも、実際に高速化したい処理を手でasm.jsで書くのは正直厳しいという印象。githubで "use asm"しているコードを探したら行列演算ライブラリが出てきましたが、ヒープ操作している所が全く読めなくてやばい。


このエントリーをはてなブックマークに追加