2013-08-11

RabbitMQ 3.1の導入とCluster構成を検証する

RabbitMQ 3.1の導入と冗長化の検証をしたのでメモ。
検証のための構成はフロントのAPサーバー、RabbitMQが動作するキューサーバー、ワーカーそれぞれ二台づつ。キューサーバーが片方死んでも全体が動作し続けられる事、両方がダウンしたとしてもデータは損失しない事が確認できれば良い。要するに単一障害点にならないようにRabbitMQを使いたい。


サーバーの準備

仮想マシン6台はVagrantを使えば一発で用意できる、メモリ16GB積んでてよかった。ホスト名を後でいじるとrabbitmqctlで停止・再起動がうまくいかなくなった。ホスト名周りはEC2で使う時に面倒な事になりそうだ。

各サーバーの /etc/hosts にrabbit1とrabbit2は追加しておく。

RabbitMQ 3.1 のインストール

APTリポジトリの追加が必要、公式ページに手順があるのでその通りに。

起動確認

vagrant@rabbit1:~$ sudo rabbitmq-server
vagrant@rabbit2:~$ sudo rabbitmq-server

管理画面の有効化

vagrant@rabbit1:~$ sudo rabbitmq-plugins enable rabbitmq_management 
vagrant@rabbit1:~$ sudo rabbitmqctl stop
vagrant@rabbit1:~$ sudo rabbitmq-server

vagrant@rabbit2:~$ sudo rabbitmq-plugins enable rabbitmq_management 
vagrant@rabbit2:~$ sudo rabbitmqctl stop
vagrant@rabbit2:~$ sudo rabbitmq-server

それぞれのサーバーのポート15672で管理画面が起動する(2.x系の場合は55672)。Basic認証がかかっているが有効化直後は guest/guest で参照できる。

疎通テスト

クラスタ構成にする前にそれぞれのrabbitmqノードと疎通できるかチェックする。Hello Worldが届けばOK。
# sender.py
import pika

params = pika.ConnectionParameters('rabbit1')
connection = pika.BlockingConnection(params)
channel = connection.channel()
# Make Queue
channel.queue_declare(queue='mq_test')
# Publish
channel.basic_publish(
                exchange='',
                routing_key='mq_test',
                body='Hello World',
                )
print " [x] sent Hello World"
# receiver.py
import pika

params = pika.ConnectionParameters('rabbit1')
connection = pika.BlockingConnection(params)

channel = connection.channel()
channel.queue_declare(queue='mq_test')

def callback(ch, method, properties, body):
    print " [x] Received %r" % (body,)

channel.basic_consume(callback, queue='mq_test', no_ack=True)
channel.start_consuming()

メッセージの永続化

先のPublisherのコードだと、receiverがメッセージを受け取る前にrabbitmqを停止させるとキューの内容が消失した。それではまずいのでキューとメッセージにオプションを追加する。
# durable=True オプション付きでキューを宣言する
channel.queue_declare(queue='cluster_test', durable=True)
# 永続化オプション付きでメッセージをpublishする
channel.basic_publish(
                exchange='',
                routing_key='cluster_test',
                body=msg,
                properties=pika.BasicProperties(
                        # To Persistent
                        delivery_mode=2,
                )
        )

管理画面上でキューのパラメータに[D]と表示され、rabbitmqの起動再起動を繰りかえしても内容が保持されるようになった。

ACKの送出

先のComsumerの実装だと、ワーカーが正常に処理を完了したかどうかに関係無くキューのメッセージが消える。正常応答がComsumerから返ってきた場合のみキューのメッセージが消えるようにするには次の通り。
def callback(ch, method, properties, body):
    print " [x] Received %r" % (body,)
    # ackを返す (返さないとキューから消えない)
    ch.basic_ack(delivery_tag = method.delivery_tag)

# no_ack=Trueを削除
channel.basic_consume(callback, queue='mq_test')

Cluster化

次はrabbit1とrabbit2をクラスタ構成にする。まずは各ノードのerlang cookie (/var/lib/rabbitmq/.erlang.cookie) を同じにしてそれぞれ再起動。
rabbit2をrabbi1に参加させるには次のコマンド。
vagrant@rabbit2:~$ sudo rabbitmqctl stop_app
vagrant@rabbit2:~$ sudo rabbitmqctl join_cluster rabbit@rabbit1
vagrant@rabbit2:~$ sudo rabbitmqctl start_app
クラスタの状態を確認、二つともdiskノードになっている。
vagrant@rabbit2:~$ sudo rabbitmqctl cluster_status
ls: cannot access /etc/rabbitmq/rabbitmq.conf.d: No such file or directory
Cluster status of node rabbit@rabbit2 ...
[{nodes,[{disc,[rabbit@rabbit1,rabbit@rabbit2]}]},
 {running_nodes,[rabbit@rabbit1,rabbit@rabbit2]},
 {partitions,[]}]
…done.

いずれかのrabbitmqノードに送信する様にPublisherを改造する

HAProxyを各APサーバーに載せるのが硬そうだが、この場では生きているrabbitmqノードに接続できるまでランダムに選ぶというナイーブな get_connection を実装した。
# sender.py (ap1)
import random
import pika

def get_connection():
    mq_clusters = ['rabbit1', 'rabbit2']
    random.shuffle(mq_clusters)
    for mq in mq_clusters:
        try:
            params = pika.ConnectionParameters(mq)
            connection = pika.BlockingConnection(params)
            return connection
        except Exception, e:
            print("Try next node")
    raise Exception("Cannot establish connection")

def send(con, msg):
    channel = con.channel()
    # 同じなので中略

for i in xrange(1, 1000):
    con = get_connection()
    msg = 'From AP1 to %s: %i' % (con.params.host, i)
    send(con, msg)
    con.close()

実行結果

# AP1
[x] sent From AP1 to rabbit1: 900 
[x] sent From AP1 to rabbit1: 901 
[x] sent From AP1 to rabbit1: 902 
[x] sent From AP1 to rabbit1: 903 
[x] sent From AP1 to rabbit1: 904 
[x] sent From AP1 to rabbit1: 905 
[x] sent From AP1 to rabbit2: 906 
[x] sent From AP1 to rabbit1: 907 
[x] sent From AP1 to rabbit1: 908 
[x] sent From AP1 to rabbit2: 909 

# AP2
[x] sent From AP2 to rabbit2: 815
[x] sent From AP2 to rabbit1: 816
[x] sent From AP2 to rabbit2: 817
[x] sent From AP2 to rabbit2: 818
[x] sent From AP2 to rabbit2: 819
[x] sent From AP2 to rabbit2: 820
[x] sent From AP2 to rabbit1: 821
[x] sent From AP2 to rabbit1: 822
[x] sent From AP2 to rabbit2: 823
[x] sent From AP2 to rabbit1: 824
 
 # Worker1
[x] Received 'From AP1 to rabbit1: 903'
[x] Received 'From AP1 to rabbit1: 904'
[x] Received 'From AP1 to rabbit1: 905'
[x] Received 'From AP2 to rabbit2: 820'
[x] Received 'From AP1 to rabbit1: 907'
[x] Received 'From AP1 to rabbit1: 908'
[x] Received 'From AP2 to rabbit2: 823'

# Worker2
[x] Received 'From AP1 to rabbit1: 900'
[x] Received 'From AP1 to rabbit1: 901'
[x] Received 'From AP1 to rabbit1: 902'
[x] Received 'From AP2 to rabbit2: 817'
[x] Received 'From AP2 to rabbit2: 818'
[x] Received 'From AP2 to rabbit2: 819'
[x] Received 'From AP1 to rabbit2: 906'
[x] Received 'From AP2 to rabbit1: 821'
[x] Received 'From AP2 to rabbit1: 822'
[x] Received 'From AP1 to rabbit2: 909'
[x] Received 'From AP2 to rabbit1: 824'

これで上手くいったかと思いきや、rabbit1を停止させるとrabbit2にメッセージを投げた時にエラーが返ってくるようになる。
pika.exceptions.ChannelClosed: (404, "NOT_FOUND - home node 'rabbit@rabbit1' of durable queue 'cluster_test' in vhost '/' is down or inaccessible")
キューの内容がrabbit1にしか保持されていないからだ。rabbit2は生きているがrabbit1のキューにアクセスできなければ何もできない。

キューをミラーリングする設定

特定のキューの内容をクラスタの全てのノードにも持たせるには rabbitmqctl で ha-mode を指定する。
vagrant@rabbit1:~$ sudo rabbitmqctl set_policy all 'cluster_test' '{"ha-mode": "all"}'
vagrant@rabbit2:~$ sudo rabbitmqctl set_policy all 'cluster_test' '{"ha-mode": "all"}' 
キューの指定には正規表現が使えるので、全てのキューをミラーリングするには
sudo rabbitmqctl set_policy all '^.*' '{"ha-mode": "all"}'
としても良い。これで、rabbit1を落してもrabbit2だけで動作するようになった。管理画面でもミラーリングができているか確認ができる。


停止したノードはそのまま再起動でOK、元のクラスタ構成に戻る。

参考


このエントリーをはてなブックマークに追加

2013-07-18

アラビア語の学習環境を整える

思い立ってアラビア語の勉強をはじめたので、やった事をまとめる。

キーボードの設定

まずはMacのキーボードでアラビア語の入力をできるようにした。手順は「システム環境設定」→「言語とテキスト」→「入力ソース」からアラビア語入力ソースにチェックを入れるだけ。しかしここで入力方式が3つあり、どれにするか早速悩む。
ArabicとArabic - PCについてはWikipediaのアラビア語キーボード配列の項目に記載があった。Arabic - QWERTYについてはよくわからなかったので実際に触ってみた。配列は次のとおり。

ا(アリフ)がa、ب(バー)がbといった風に音感が似てるローマ字アルファベットにマッピングされている。配列の歴史的な経緯はどうでも良かったので、すぐに体が覚えられそうなArabic - QWERTYを使う事にした。السلام عليكم(アッサラーム アレイコム)と打ちたい場合は alslam elikm である。直感的に打てて良い。なぜかArabic - QWERTYの状態ではctrl + shift+ ]でChromeのタブの切り替えができなくて不便。

勉強用テキスト

Amazonで良さそうなのを二冊購入した。最初は全くアラビア語が読めないので単語を覚える事ができない、まずは書き取りから初めて単語が読める状態になるのを目指した。どちらも本にガリガリ書き込んで練習するタイプの本。
読める書けるアラビア文字練習プリント読める書けるアラビア文字練習プリント
アルモーメン アブドーラ,Al moamen Abdalla

小学館
売り上げランキング : 65350
Amazonで詳しく見る
アラビア語が面白いほど身につく本―文字から旅行会話までマスターできる (語学・入門の入門シリーズ)アラビア語が面白いほど身につく本―文字から旅行会話までマスターできる (語学・入門の入門シリーズ)
アルモーメン・アブドーラ,本田 孝一,Al moamen Abdalla

中経出版
売り上げランキング : 100014
Amazonで詳しく見る

カリグラフィ万年筆

最初はボールペンで書きとり練習をやっていたのだが、あの独特の雰囲気が出せず面白味に欠ける。そこで、カリグラフィ用万年筆があるとの事で使ってみた。アラビア書道用の物では無いが、太い線が引けるので雰囲気が出る。記事タイトル直下の画像がカリグラフィ万年筆で書いた文字。
パイロット万年筆 プレラ カリグラフィ 透明ブラック FPRN-350R-TBCMパイロット万年筆 プレラ カリグラフィ 透明ブラック FPRN-350R-TBCM
㈱パイロットコーポレーション
売り上げランキング : 18793
Amazonで詳しく見る

学習支援アプリの導入

AppStoreで探してもあまり数が無いので、見つかったアプリを全て試した。L-Lingoという奴が繰り返し練習できて良さげ。

L-Lingo アラビア語を学ぼう 5.03(無料)App
カテゴリ: 教育, 辞書/辞典/その他
販売元: Smart Language Apps Limited - Smart Language Apps Limited(サイズ: 85.9 MB)
全てのバージョンの評価: 無し(0件の評価)


このエントリーをはてなブックマークに追加

2013-07-06

iPython Notebook用のChefのCookbookを書いた

iPython Notebookが0.13.2にバージョンアップして、セットアップが自動化できそうな雰囲気がしたので勉強中のChefのcookbookにした。

iPython Notebookのパッケージインストール

apt-get install ipython-notebook で入るようになったので、これまでとは比較にならないぐらい簡単になった。レシピは次の通り。ipython-notebook本体と必要なパッケージをインストールする。
# Install packages
%w{
  python-pandas
  python-numpy
  python-scipy
  python-matplotlib
  python-nose
  ipython-notebook
}.each do |pkg|
  package pkg do
    action :upgrade
  end
end

# iPython needs sympy 0.7.2
# So use [pip install] instead of package install (0.7.1).
python_pip "sympy"
sympyだけはaptで降ってくるバージョンが古くて動作しなかったので、pipで入れている。

iPython Notebookの起動

サーバー起動時にiPython Notebookも起動して欲しいので起動もレシピにした。内容は

  • 起動ユーザー(ipynb)の作成
  • プロファイル配置ディレクトリの作成
  • 起動スクリプトの配置
  • 起動

デーモン化が面倒だったので nohup で起動するようにした。レシピは次の通り。
# Create launch user
group 'ipynb' do
  group_name 'ipynb'
  action :create
end

user 'ipynb' do
  comment 'User for ipython notebook'
  gid 'ipynb'
  home '/home/ipynb'
  shell '/bin/bash'
  supports :manage_home => true
  action :create
end

# Add to staff group
group 'staff' do
  action :modify
  members ['ipynb']
  append true
end

# Create serve directory
directory '/web/' do
  owner 'ipynb'
  group 'staff'
  mode '0775'
  action :create
end

directory '/web/ipython-notebook/' do
  owner 'ipynb'
  group 'staff'
  mode '0775'
  action :create
end

# 起動スクリプトの配置
template '/web/ipython-notebook/launch.sh' do
  source "launch.sh.erb"
  owner 'ipynb'
  group 'staff'
  mode 00776
end

bash 'Launch ipython notebook' do
  user 'ipynb'
  group 'staff'
  cwd '/web/ipython-notebook/'
  code >>-EOC
    nohup ./launch.sh restart
  EOC
end
起動スクリプトテンプレート、起動オプションのいくつかはAttributeから渡す。
#!/bin/bash

pid=`dirname $0`/ipynb.pid
port=<%= node['ipython-notebook']['port'] %>
ip=<%= node['ipython-notebook']['ip'] %>
ipythondir=`dirname $0`/.ipython

start() {
    if [ -f $pid ]; then
        echo "running already. pid: `cat $pid`";
        return 1;
    else
        cd `dirname $0`
        ipython notebook --pylab=inline --port=$port --ip=$ip --ipython-dir=$ipythondir &
        echo $! > $pid
    fi
}

stop() {
    if [ -f $pid ]; then
        kill `cat $pid`
        rm -f $pid
    else
        echo "Not running";
    fi
}

restart() {
    stop
    start
}

case "$1" in
  start)
    start
    ;;
  stop)
    stop
    ;;
  restart)
    restart
    ;;
  *)
    echo $"Usage: $0 {start|stop|restart}"
    exit 1
esac

exit $?

動作確認

インスタンス起動後にチェック
$ ps aux | grep python
ipynb    23612  0.0  4.0 188952 20172 ?        S    13:24   0:02 python /usr/bin/ipython notebook --pylab=inline --port=8888 --ip=* --ipython-dir=./.ipython
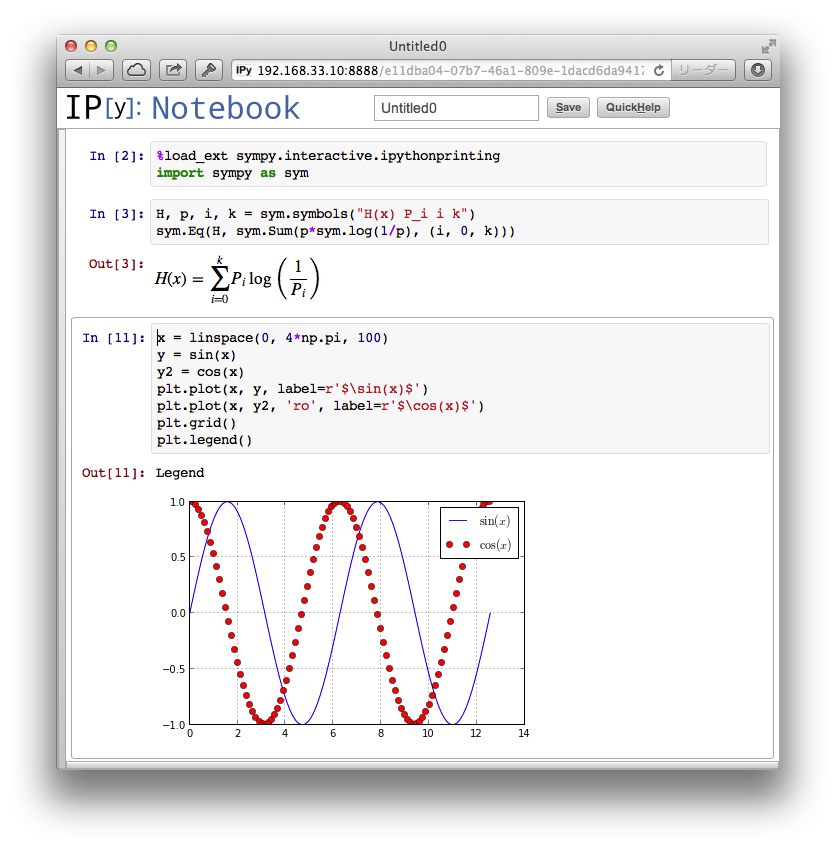
 実際に使ってみる。
OK。あとはbitbucketのプライベートリポジトリで管理しているノートをgitで引っぱってこれば個人的な要件は満たせる。

このエントリーをはてなブックマークに追加

2013-06-07

IDC FrontierさんからNASAハッカソンについて取材を受けました

NASAハッカソンのスポンサーであり、Cloudless spotチームにIDCFクラウドを無料で提供していただいたIDCFさんから受けた取材が記事になっています。 今はとにかく事例が欲しいとの事なので、後で紹介できそうな使い方であればハッカソンでもなんでも使わせてもらえそうな雰囲気でした。

このエントリーをはてなブックマークに追加

2013-06-03

NASAハッカソンでGalactic Impact部門のHonorable Mentionを受賞しました

グローバル審査の結果が出たのでエントリにします。

世界規模のハッカソンであるInternational Space Apps Challengeが4月に開催されました。昨年も同じ時期に開催されましたが、今回は開催地が44カ国、83都市。正式にサブミットされたプロジェクトは750を越えたとの事で、圧倒的な規模です。

私が参加したプロジェクトは日本ローカル2位*1となり、グローバル審査ではGalactic Impact部門のHonorable Mention(選外佳作)となりました。ハッカソンから1ヶ月以上経っていますが、今だに作業は続いているので嬉しい限りですね。

主に次の3つの機能を開発しました。
  • MODIS Cloud Maskの取りこみ、集計
  • 地図上へのマッピング
  • ソーラーパネル発電による収支のシミュレーション

サブミットしたプロジェクトページ
ソースコード (github), デモサイト

快晴率のマッピング
雲の影響を計算モデルに取りいれたソーラーパネル発電による収支のシミュレーション

二日間のハッカソン

私は、全地球上過去30年分の雲の衛星データ、MODIS Cloud Maskを利用して、太陽光エネルギーが効率良く得られる場所が見つけられるシステムを構築しようというチームに参加しました。メンバーは10人、本職のWebエンジニアが半分、エネルギーや気象方面の研究に係っている方が半分というバランスの良い構成でした。

by akiko yanagawa

とはいえ開始から発表まで30時間弱しかなく、途中MongoDBへのinsertが思ったようなパフォーマンスが出ないトラブルが発生し、処理対象のデータは日本(北緯20°~50°, 東経120°~150°)の10年分に限定する事に。

処理対象の範囲を限定したと言っても、ダウンロードしたMODISのデータは100GByte、12年分のデータが9億7000万レコードとなったのでサーバーリソースもそれなりに必要に。サーバーはスポンサー提供のIDCFクラウドが使えたので、並列処理できる所はインスタンスをガンガン追加してしのぎました。*2

この時の作業をざっと挙げると。
  • データ回り
    • MODIS Cloud Maskのデータ形式の調査
    • ダウンロードサイトから日時と領域(緯度経度)を指定して必要データを延々と落すダウンローダーの開発
    • MongoDBへの投入
    • MapReduceで集計
  • アプリケーション回り
    • ソーラーパネルの発電量の計算モデルの作成
    • アプリケーションの設計
    • サーバーサイドの開発(Ruby on Rails)
    • クライアントの開発(JavaScript)
    • Webデザイン
  • その他
    • サーバー確保
    • プロジェクトのサブミット
    • 発表準備
チームメンバーに恵まれた事もあり、スタンドプレーから生まれるチームワークとも言うべき分業体制でそれっぽく動く物が完成。発表準備はリーダーが粛々と進めており、プロジェクトの壮大な展望をプレゼン、ローカル審査は全18チーム中の2位となりました。

by akiko yanagawa

グローバル審査へ

ハッカソンの後、グローバル審査へのサブミット締切までは一週間、その間にプロジェクトの解説動画を作り、プロジェクトページを完成させなければなりません。ろくに寝ていない状況でそれを聞いてメンバー全員が沈黙。
アプリは審査に耐えられる状態では無かったのでチューニングが必要でした。私はデータの精度アップのためにひたすら積み上げ計算処理を流していました。このあたりで一回の集計が24時間を越えたのでもうMongoDBはやめてHadoopか何かしよう……と強く思ったのでした。

まとめ


  • MongoDBのMapReduceは1CPUしか使ってくれなくて辛かった
  • 集計結果をプロットするRのプログラムのバグが今だに取れなくて泣きそう
  • 太陽光エネルギーの利用法(ソーラーパネルと藻)について詳しくなった
  • 普段合う事のない、別の分野のプロフェッショナルと一緒に物を作れるのは楽しい


*1:  ローカル審査で1位と2位のプロジェクトがグローバル審査に進むルール。
*2:  最終的に管理画面で利用額を見たら4月と5月あわせて200万円ぐらいになっていた……、IDCFさん本当にスポンサーありがとうございました。(今も使わせてもらってます)

このエントリーをはてなブックマークに追加